Описание
Ссылка на публичный репозиторий: https://git.angara.cloud/gbgreenplum/greenplum.monitoring
Пакет greenplum.monitoring представляет собой набор компонентов мониторинга кластера GreenPlum, необходимых для сбора метрик, визуализации данных и создания дашбордов.
Основные компоненты greenplum.monitoring:
- Prometheus – программное приложение для мониторинга систем и оповещения о событиях
- Node exporter и SQL exporter – приложения для сбора и отправки метрик о системе в Prometheus
- Grafana – программная система для визуализации метрик мониторинга
- Alertmanager - система алертинга
Подробнее компоненты пакета greenplum.monitoring описаны в соответствующих разделах ниже.
Перед началом работы с пакетом greenplum.monitoring необходимо выполнить установку и настройку. Подробнее на соответствующих страницах:
Prometheus
# my global config
global:
  scrape_interval: 60s # Set the scrape interval to every 15 seconds. Default is every 1 minute.
  evaluation_interval: 15s # Evaluate rules every 15 seconds. The default is every 1 minute.
  scrape_timeout: 60s # scrape_timeout is set to the global default (10s).

# Alertmanager configuration
alerting:
  alertmanagers:
    - static_configs:
        - targets:
          # - alertmanager:9093

# Load rules once and periodically evaluate them according to the global 'evaluation_interval'.
rule_files:
  # - "first_rules.yml"
  # - "test_rules.yml"

# A scrape configuration containing exactly one endpoint to scrape:
# Here it's Prometheus itself.
scrape_configs:
  # The job name is added as a label `job=` to any timeseries scraped from this config.
  - job_name: "prometheus"

    # metrics_path defaults to '/metrics'
    # scheme defaults to 'http'.

    static_configs:
      - targets: ["localhost:9090"]
#    relabel_configs:
#      - source_labels: ['__address__']
#        separator:     ':'
#        regex:         '(.*):.*'
#        target_label:  'instance'
#        replacement:   '${1}'
  - job_name: node
    static_configs:
      - targets: ["localhost:9100"] #linux hosts list
#    relabel_configs:
#      - source_labels: ['__address__']
#        separator:     ':'
#        regex:         '(.*):.*'
#        target_label:  'instance'
#        replacement:   '${1}'
  - job_name: sql_exporter
    static_configs:
      - targets: [''] #sql exporter host :9399
#    relabel_configs:
#      - source_labels: ['__address__']
#        separator:     ':'
#        regex:         '(.*):.*'
#        target_label:  'instance'
#        replacement:   '${1}'
  - job_name: pxf_exporter
    metrics_path: /actuator/prometheus
    static_configs:
      - targets: [""] #PXF hosts list :5888
#    relabel_configs:
#      - source_labels: ['__address__']
#        separator:     ':'
#        regex:         '(.*):.*'
#        target_label:  'instance'
#        replacement:   '${1}'

  - job_name: grafana
    metrics_path: /metrics
    static_configs:
      - targets: ["localhost:3000"]
Grafana
Дашборды Grafana
Ниже перечислены основные дашборды для мониторинга различных компонентов кластера GreenPlum:
-
Greenplum.Cluster.dashboard- агрегатный дашборд состояния кластера Greenplum:- Статус кластера, сегментов и сервисов
- Информация о потреблении CPU на всех хостах кластера
- Информация о потреблении RAM на всех хостах кластера
- Информация об использовании дисков и swap на всех хостах кластера
- Список созданных ресурсных групп и расписание их действия
- Информация о запущенных сессиях и пользовательской активности
-
Node.Exporter.Full.dashboard- детальный дашборд состояния хостов кластера. Основан на стандартном дашборде Node Exporter из библиотеки Grafana. -
Prometheus.Stats.dashboard- стандартный дашборд мониторинга Prometheus. Отображает метрики работы самой системы мониторинга Prometheus. -
Greenplum.PXF.dashboard- дашборд мониторинга PXF:- Список серверов PXF
- Текущее и историческое количество соединений
- Количество полученных и отправленных байт
- Использование RAM в разрезе инстанса
-
Greenplum.Resource.Groups.dashboard- детальный дашборд ресурсных групп:- Текущее потребление CPU в разрезе ресурсной группы и история потребления
- Текущее потребление RAM в разрезе ресурсной группы и история потребления
- Текущее и историческое значение активных запросов в разрезе ресурсной группы
- Текущий объем spill-файлов в разрезе ресурсной группы
- Количество распределенных ресурсов кластера между ресурсными группами
- Актуальные квоты ресурсных групп и расписание их изменений
Подробное описание основных дашбордов Grafana см. на странице Описание дашбордов Grafana.
Способы анализа дашбордов
Сравнение параметров
Мониторингом собираются разные параметры. Сравнение параметров нагрузки может быть использовано для сравнения общего состояния кластера или для сравнения определенной нагрузки.
Сравнение параметров CPU
Основной инструмент сравнения нагрузок на CPU кластера это дашборд Grafana cluster, блок CPU Busy.
На графике этой панели указаны нагрузки в процентном отношении относительно максимума возможной загрузки. Также можно выбрать график нагрузки на определенную машину кластера.
Нагрузка на сегмент-хосты
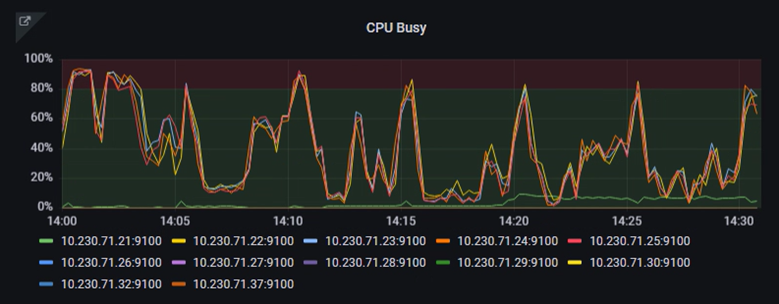
Как правило, нагрузка на сегмент-хостах распределена равномерно и графики между собой практически неразличимы. Различие нагрузок в конкретный момент времени не является критическим показателем, однако повторяющийся тренд на одном и том же сегменте сигнализирует о неравномерном и/или неоптимальном распределении запросов.
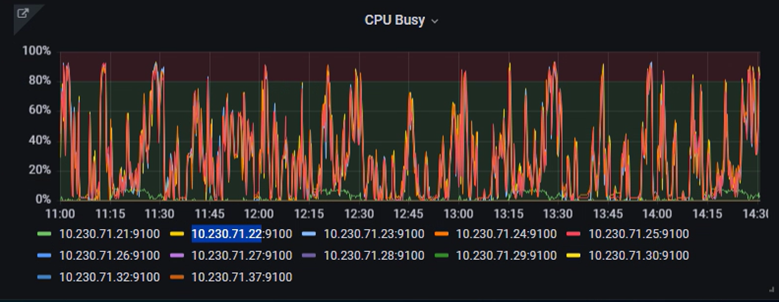
В кластере с разноплановыми нагрузками и конкурирующими за память потоками может наблюдаться рассинхронизация между графиками различных сегментов.
Если графики имеют сходный вид, это может быть вызвано опережением или запаздыванием параллельных потоков из-за неравномерного распределения нагрузки.
Характерный пример: поток 1 создал более сложную нагрузку на хост-сегменте 2 из-за особенностей дистрибуции данных, в результате чего поток 2 на хост-сегменте 1 начал и завершил вычисления раньше, чем аналогичный поток на хост-сегменте 2.
Данное явление не является проблемным при условии, что графики остаются визуально схожими по форме и рассинхронизация не становится критически большой.
Нагрузка на мастер-хост
Как правило, нагрузка на мастер-хост минимальна. Для нагрузки на мастер, отличной от обычной, нужны операции, активно изменяющие метаданные.
Работа stand by мастера не рассматривается как существенная нагрузка для кластера, поскольку он функционирует в режиме журналирования основного мастера.
Сравнение параметров памяти
Greenplum использует всю свободную оперативную память на сегмент-хостах для использования в качестве кеша и/или буфера для диска на уровне ОС. Это является ожидаемым и предпочтительным поведением, так как ускоряет операции чтения. Подобным образом выделенная память будет отдана первому нуждающемуся приложению.
Однако такая оптимизация усложняет работу сравнения параметров памяти, так как панелью на Greenplum cluster собирается процент занятой оперативной памяти, а команды ps, htop и free при некоторых манипуляциях помогут узнать значение в моменте, но не тренд.
Для детального анализа фактического использования памяти рекомендуется использовать дашборд Node.Exporter.Full.dashboard.
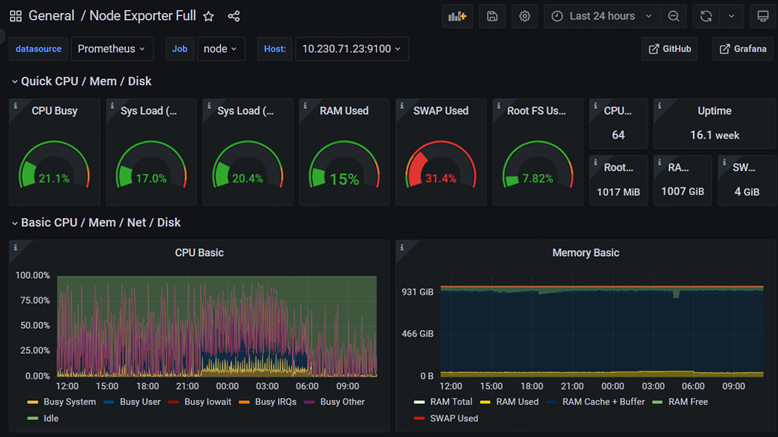
Для поиска графика занятой памяти на нужном сегменте необходимо:
- Зайти на дашборд
Node.Exporter.Full.dashboard - Выбрать в раскрывающемся меню Host нужный хост (в данном примере подойдет любой сегмент-хост)
- Перейти на панель Memory Basic
- Выбрать график RAM Used
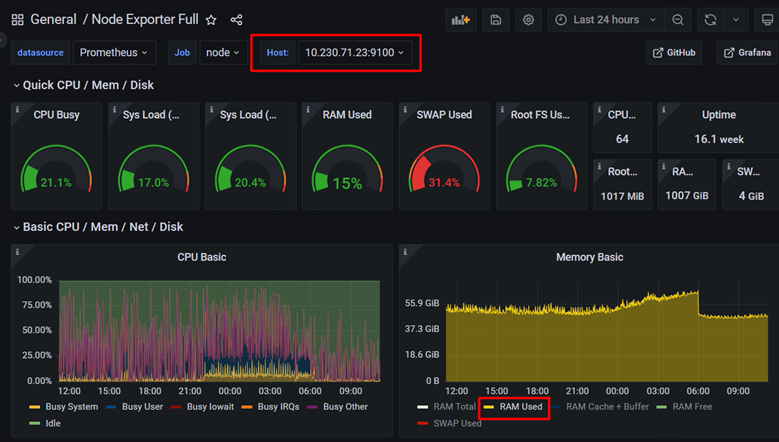
Отдельно стоит отметить, что в данном параметре учтены все приложения, использующие оперативную память в работе.
Формула: используемая память = вся память - (свободная память + кешированная память + буферная память + освобождаемая память).
Результаты данных вычислений можно подтвердить с помощью команд ps и free.
Группы и их ресурсы
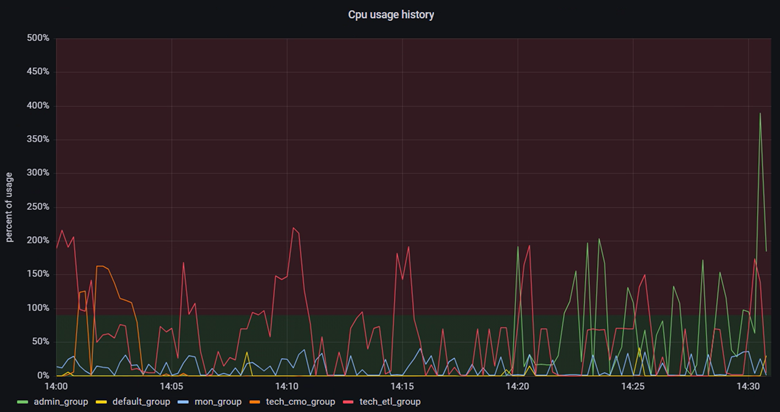
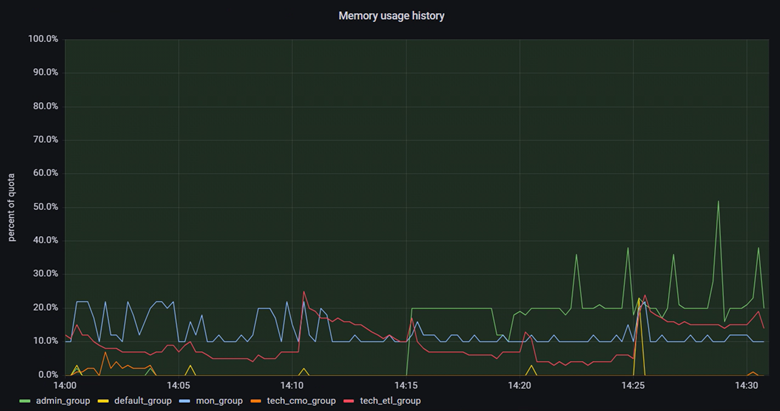
Нагрузку на ресурсы можно сравнить в разрезе потребляемого процента от выделенного группе ресурса.
CPU в процентах от выделенного ресурса
Память в процентах от выделенного ресурса
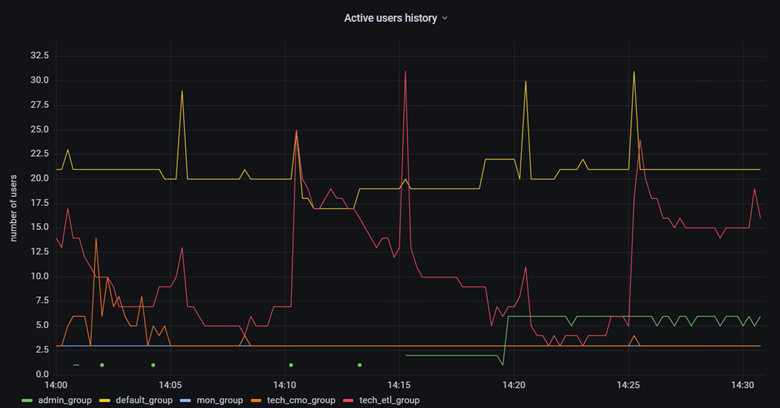
Подключения показательны, когда необходимо понять долю ресурса группы, выделяемую на подключение в определенный момент времени.
Используемые подключения в абсолютных значениях (Concurrency)
Alertmanager
Список правил и реакций на алерты
| Правило | Наименование алерта | Реакция на алерт |
|---|---|---|
| Утилизация CPU более 75% в течение 30 минут | HighCPUUtilization |
• Проанализировать потребление ресурсов с помощью команды htop• При наличии процессов GreenPlum: - Проверить pg_stat_activity на предмет блокировок- Проанализировать количество активных сессий • При отсутствии процессов GreenPlum: - Передать проблему системным администраторам |
| Утилизация раздела HDD более 50% в течение 10 минут | HighIOUsage |
• Проверить кластер на наличие spill-файлов • Проанализировать объекты с большим количеством захваченных блокировок • Найти проблемный запрос со spill-операциями и по согласованию завершить сессию |
| Средний размер очереди диска более 90 в течение 10 минут | DiskQueueLengthHigh |
• Проверить кластер на наличие spill-файлов • Проанализировать объекты с большим количеством захваченных блокировок • Найти проблемный запрос со spill-операциями и по согласованию завершить сессию |
| Общее количество соединений более 650 | LargeNumberConnections |
• При большом количестве сессий в idle: - Завершить их, начиная с наиболее длительных • При большом количестве активных сессий: - Проанализировать блокировки - При необходимости завершить сессию, удерживающую ресурс • При большом количестве сессий в IIT (idle in transaction): - Согласовать и завершить аномальные сессии |
| Суммарный объем spill-файлов более 600 GB | HighSpillUsage |
• Найти сессию, генерирующую spill-файлы • Согласовать и завершить проблемную сессию |
| Массовая блокировка - более 30% сессий в ожидании | ManyLockedSessions |
• При большом количестве активных сессий - проанализировать блокировки • При необходимости завершить сессию, удерживающую ресурс |
| Ожидание ресурсных групп более 5 минут | WaitingReasonResgroup |
• Проанализировать сессии на предмет блокировок • При большом количестве активных сессий - проанализировать блокировки, при необходимости завершить сессию, удерживающую ресурс • При большом количестве сессий в IIT - согласовать и завершить аномальные сессии приложения |
| Перекос данных | - Контроль через дашборд Schema Size |
• Уведомить команду разработки данных • Проанализировать распределение данных через дашборды мониторинга |
| Избыточное количество партиций | ManyPartitions |
• Уведомить команду разработки данных |
| Недостаточное количество партиций | LowPartitions |
• Проверить логи системы управления партициями • Проверить расписание cron • Написать на почту alfa_gp_support@glowbyteconsulting.com |
| Утилизация файловой системы более 80% | DiskSpaceUtilization |
• Удалить лишние/временные файлы в целевой точке монтирования • При сомнениях обратиться к системным администраторам • Проверить логи и WAL-файлы |
| Idle-транзакции | - Контроль через дашборд Schema Size |
• Проанализировать сессии на предмет блокировок • Завершить длительные idle-сессии, начиная с наиболее продолжительных |
| Недоступность серверов, узлов, кластеров | - |
• Проанализировать логи системы • Устранить причину недоступности • Восстановить работу кластеров и сервисов • При невозможности быстрого восстановления - переключиться на DR |
Logs Exporter
Набор конфигураций сервисов fluent-bit и filebeat для экспорта логов GreenPlum и PXF в формате CSV в систему Elasticsearch.
В состав fluent-bit входят следующие файлы:
parsers.conf- парсинг многострочных логов GreenPlum и PXF, а также отдельных записей логовpsql_log_parser.lua- Lua-скрипт для парсинга логов GreenPlum
В состав filebeat входят следующие файлы:
filebeat.yml- основная конфигурация со всеми парсерамиgpdb_parser.js- JavaScript-скрипт для парсинга логов GreenPlum, функционально идентичныйpsql_log_parser.lua
Exstension
Exstension do_awh_synthetics
Расширение cодержит в себе объекты схемы do_awh_synthetic_schem для генерации синтетики (схем и таблиц):
- Таблица
do_awh_synthetic_schem.created_schemas- инфорация о созданных синтетических схемах - Функция
do_awh_synthetic_schem.get_sql_partition_block- генератор описания партиций для таблицы - Функция
do_awh_synthetic_schem.create_syntetic_database_objects- создание схемы с HEAP/AOT/COLUMN таблицами и одной строкой - Функция
do_awh_synthetic_schem.drop_syntetic_database_objects- возвращает таблицу с выражениями для удаления синтетических схем
Рекомендации для запуска
-
На основе опыта промышленных систем рекомендуется создавать около 60 схем при использовании параметров по умолчанию, из которых 7 должны содержать партиции. При такой конфигурации итоговый объем синтетических данных на каждом хосте кластера с учетом mirror-сегментов составляет приблизительно 80 ГБ.
-
При использовании функции
do_awh_synthetic_schem.create_syntetic_database_objectsсо стандартными параметрами не рекомендуется создавать более 2 схем с параметрами по умолчанию, поскольку это может привести к ошибкам из-за одновременной вставки в большое количество AOT таблиц или превышения ограничений памяти.
Порядок стандратной работы для тестирования
- Установить расширение
- Подготовить скрипт для создания схем с использованием функции
do_awh_synthetic_schem.create_syntetic_database_objects()для достижения необходимого количества синтетических объектов (с параметрами по умолчанию рекомендуется 60 схем).
Пример:
    --Запуск в DBeaver через Alt+X
    select do_awh_synthetic_schem.create_syntetic_database_objects();
    select do_awh_synthetic_schem.create_syntetic_database_objects();
    select do_awh_synthetic_schem.create_syntetic_database_objects();
    select do_awh_synthetic_schem.create_syntetic_database_objects();
    select do_awh_synthetic_schem.create_syntetic_database_objects();
    select do_awh_synthetic_schem.create_syntetic_database_objects();
    select do_awh_synthetic_schem.create_syntetic_database_objects();
    select do_awh_synthetic_schem.create_syntetic_database_objects(num_of_schem_partition := 0);
    select do_awh_synthetic_schem.create_syntetic_database_objects(num_of_schem_partition := 0);
    select do_awh_synthetic_schem.create_syntetic_database_objects(num_of_schem_partition := 0);
    select do_awh_synthetic_schem.create_syntetic_database_objects(num_of_schem_partition := 0);
    select do_awh_synthetic_schem.create_syntetic_database_objects(num_of_schem_partition := 0);
    select do_awh_synthetic_schem.create_syntetic_database_objects(num_of_schem_partition := 0);
    select do_awh_synthetic_schem.create_syntetic_database_objects(num_of_schem_partition := 0);
    select do_awh_synthetic_schem.create_syntetic_database_objects(num_of_schem_partition := 0);
do_awh_synthetic_schem.drop_syntetic_database_objects() и запустить их.
5. Выполнить фулл вакуум для pg_catalog.
6. Удалить extension
Описание работы
Для создания схем необходимо использовать функцию do_awh_synthetic_schem.create_syntetic_database_objects со следующими параметрами:
num_of_schem- количество создаваемых схем (по умолчанию 2)num_of_heap_table- количество создаваемых HEAP таблиц в каждой схеме (по умолчанию 10)num_of_aot- количество создаваемых AOT таблиц в каждой схеме (по умолчанию 20)num_of_columntypetable- количество создаваемых COLUMN таблиц в каждой схеме (по умолчанию 2400)num_of_view- количество создаваемых View в каждой схеме (по умолчанию 15)num_of_schem_partition- количество схем с партициями (по умолчанию 1)num_of_table_partition_10- количество таблиц с 10 партициями (по умолчанию 10)num_of_table_partition_50- количество таблиц с 50 партициями (по умолчанию 6)num_of_table_partition_200- количество таблиц с 200 партициями (по умолчанию 2)
Создание схем
При запуске функции do_awh_synthetic_schem.create_syntetic_database_objects создаются схемы с наименованием в формате test_schema_YYYY_MM_DD_HH_MI_SS_N с timestamp запуска функции и номером создаваемой схемы
Каждая схема содержит представления и таблицы различных типов (HEAP/AOT/COLUMN) с 10, 50 или 200 партициями или без партиций. В каждую таблицу вставляется одна строка данных.
Создание таблиц и представлений
Создание таблиц происходит в следующем порядке:
- HEAP-таблицы c 10 партициями
- HEAP-таблицы c 50 партициями
- HEAP-таблицы c 200 партициями
- HEAP-таблицы без партиций
- AOT-таблицы c 10 партициями
- AOT-таблицы c 50 партициями
- AOT-таблицы c 200 партициями
- AOT-таблицы без партиций
- COLUMN-таблицы без партиций В каждую таблицу вставляется 1 строка. По умолчанию создаются таблицы HEAP/AOT/COLUMN со следующей структурой:
CREATE TABLE test_schema_2025_02_21_18_04_33_1.heaptable1 (
    id int4 NULL,
    id2 int4 NULL,
    id3 int8 NULL,
    id4 int4 NULL,
    c_text text NULL,
    ts_part timestamp NULL,
    ts2 timestamp NULL,
    col1 int4 NULL,
    col2 int4 NULL,
    col3 int4 NULL,
    col4 int4 NULL,
    col5 int4 NULL,
    col6 int4 NULL,
    col7 int4 NULL,
    col8 int4 NULL,
    col9 int4 NULL,
    col10 int4 NULL
)
WITH (
    appendonly=false --HEAP
    --appendonly=true --AOT/COLUMN
    --orientation=column --COLUMN
)
DISTRIBUTED BY (id);
В зависимости от настроек партиций к AOT и HEAP таблицам могут быть добавлены 10, 50 или 200 партиций с интервалом в один день от текущей даты по полю ts_part.
Представления создаются для сгенерированных таблиц. При создании каждой таблицы, если текущее количество представлений не превышает заданное значение, для таблицы создается представление со следующей структурой:
CREATE OR REPLACE VIEW test_schema_2025_02_21_18_04_33_1.v_1
AS SELECT heaptable1.id,
    heaptable1.id2,
    heaptable1.id3,
    heaptable1.id4,
    heaptable1.c_text,
    heaptable1.ts_part,
    heaptable1.ts2,
    heaptable1.col1,
    heaptable1.col2,
    heaptable1.col3,
    heaptable1.col4,
    heaptable1.col5,
    heaptable1.col6,
    heaptable1.col7,
    heaptable1.col8,
    heaptable1.col9,
    heaptable1.col10
   FROM test_schema_2025_02_21_18_04_33_1.heaptable1;
Создание партиций
Партиции создаются по следующим условиям:
- Партиции создаются в схемах с 1 до
num_of_schem_partition - Партиции в 10, 50 и 200 таблиц распределяются между HEAP/AOT таблицами в следующем порядке:
- Создаются партиции для HEAP таблиц, но не более чем половина от общего числа партиций (округление в большую сторону)
- Последовательность создания: таблицы с 10 партициями, таблицы с 50 партициями, таблицы с 200 партициями, таблицы без партиций
- Если для каждого типа партиций при создании HEAP таблиц использовано более половины от общего количества, то оставшиеся HEAP таблицы создаются без партиций
- Сставшиеся партиции будут созданы для AOT таблиц аналогичным образом
- Партиции создаются начиная с текущей даты с интервалом в один день
- Для COLUMN таблиц не создаются партиции
Например, при параметрах:
num_of_heap_table= 10num_of_aot= 10num_of_column= 10num_of_table_partition_10= 5num_of_table_partition_50= 2num_of_table_partition_200= 1
Будут созданы таблицы в следующем порядке:
- 3 HEAP таблицы с 10 партициями
- 1 HEAP таблица с 50 партициями
- 1 HEAP таблица с 200 партициями
- 5 HEAP таблиц без партиций
- 2 AOT таблицы с 10 партициями
- 1 AOT таблица с 50 партициями
- 7 AOT таблиц без партиций
Финализация работы
По окончанию работы функции информация о созданных схемах помещается в таблицу do_awh_synthetic_schem.created_schemas и с помощью функции do_awh_synthetic_schem.drop_syntetic_database_objects могут быть получены скрипты для удаления синтетических схем.